检查分析路径,再规范写稿步骤
同事提交参考作品后,智能体在参考内容尚未充分分析时就开始写稿。
我的工作
我核对模型收到的是视频还是抽帧图片,与团队逐个测试候选视频分析模型;亲自制作 Skill,将先分析参考作品、再创作的要求沉淀为复用步骤。
交付结果
交付视频分析 Skill 与使用要求。输入检查用于确认处理路径,脚本中的事实、结构和可制作性仍需结合参考内容复核。
CASE 01 / 猛犸互动 · 飞书游戏内容智能体
知识检索、内容拆解、脚本初稿接入飞书。
先看我怎样排查参考材料的分析路径、制作 Skill;再看整个项目的使用记录与作品成果。
脚本耗时中位数 · 人工 / AI 辅助
去重脚本 · 成对业务自填记录
采用智能体辅助脚本 · 达人制作发布
项目整体成果,不作为本次视频分析 Skill 改进的前后对照;耗时为业务自填,统计口径见文末。
01 / 业务问题
策划需要结合游戏版本、角色、玩法和账号风格写内容。通用模型容易混淆事实,也可能生成流畅却没有重点、缺少素材或不适合制作的初稿,人工仍要反复查资料和改写。
约半个月完成搭建,同事通过飞书调用服务器上的 OpenClaw;已在原神、鸣潮、三角洲行动等项目稳定使用。
02 / 本人改进与交付
参考材料尚未充分分析时,模型就开始写稿。我从实际输入和候选模型能力入手排查,再把先分析、后创作的要求写入 Skill。
同事提交参考作品后,智能体在参考内容尚未充分分析时就开始写稿。
我核对模型收到的是视频还是抽帧图片,与团队逐个测试候选视频分析模型;亲自制作 Skill,将先分析参考作品、再创作的要求沉淀为复用步骤。
交付视频分析 Skill 与使用要求。输入检查用于确认处理路径,脚本中的事实、结构和可制作性仍需结合参考内容复核。
通用模型容易混淆不同游戏版本与机制。
整理官方资讯、角色、玩法和活动资料,保留版本、时间、条件与原始来源;持续补充游戏知识。
鸣潮活动知识补充 42 条记录,覆盖 4 个版本,供检索与内容核对使用。
工作流需要进入同事的日常工作,也需要持续维护。
在服务器部署 OpenClaw 并接入飞书,维护技能路由与知识材料,处理附件体积限制、服务连接和使用统计,配套使用指引。
同事在飞书中调用知识与脚本流程,已在多个游戏项目稳定使用。
03 / 质量判断
结合实际任务与使用反馈,关注事实、任务、结构、制作条件和最终采用。
关键事实、版本、数值是否需要人工核对,核查成本是否抵消收益?
输出是否抓住业务目的与内容成立的核心,而不是表面换词?
是否有重点、前后论据成立,删改是否超过人工重写成本?
语言是否符合账号调性,素材是否可查找,作者是否能实际制作?
有没有进入作者改稿或发布,而不只看生成速度和主观分数?
04 / 使用反馈
保留原始任务片段、反馈、耗时与评分,隐去作者身份。选择一个维度,查看运营与作者使用时的调整和结果。
真实使用记录 / 存档第 34 条
游戏CG/剧情二次剪辑
作者评分 85 分
不仅判断文案好不好读,还看角色选择是否重复、素材能否找到、作者能否执行。
提示词指出同一角色被重复列举,要求不同角色、统一口播结构,并补充素材来源;最终输出逐项给出角色与角色演示/PV等来源。
要求三转二的角色不是同一个;
推荐素材来源(方便我去收集素材);
作者直接发布
表内记录60→10分钟、85分;使用反馈明确写“作者直接发布”,并附作品链接。
最难绷的三转二,芙宁娜。
推荐素材来源:芙宁娜角色演示、枫丹主线终章舞台过场
来源:脚本测试存档。耗时与评分按原始字段展示。
真实使用记录 / 存档第 46 条
资讯
作者评分 70 分
文本是否有重点、论据能否连接、篇幅是否适合口播;流畅不等于合格。
提示词补入开头、过渡、结尾的大纲;反馈对比未建立大纲时的拖沓与补入大纲后的改善。
文案有逻辑、有考据;
大概这个大纲~
文本不建立大纲的前提下太累赘拖沓了,没有重点;
建立大纲后,文本需要删改部分,作者评价较高;
表内记录60→30分钟、70分;补大纲后仍需删改,但作者评价提高。
【终版口播文案】
来源:脚本测试存档。耗时与评分按原始字段展示。
真实使用记录 / 存档第 23 条
整活与热梗创作
作者评分 90 分
是否抓住参考内容真正成立的反差,而不只是换一组游戏角色。
原提示词保留了追问:先指出输出仍是游戏自身内容,再要求完全用现实物理问题提问,并给出“冻住水面”的例子。
你说的都是游戏自身的内容,这个视频体现的是游戏与物理直接的结合
我建议提问的时候,完全提现实物理问题
经过运营调试,这版文案很贴合需求,几乎不需要怎么更改就可以直接使用
表内记录120→30分钟、90分;反馈明确经过运营调试后,几乎不需要更改即可使用。
问题就得更像现实课堂上真的会考的物理题,而不是“游戏机制分析题”。
来源:脚本测试存档。耗时与评分按原始字段展示。
真实使用记录 / 存档第 5 条
角色养成/攻略
作者评分 60 分
对版本、装备与数值敏感的攻略,事实正确和核查成本优先于成稿速度。
作者检查攻略细节错误,再改为自己账号的文风,核查与改写占用了生成省下的时间。
每个模块都要给出带具体数值的明确标准、优先级排序
纯攻略文案对ai来说细节容易出错,作者需要排查错误再撰写合适自己账号文风的文案,花费时间较久
表内记录30→30分钟、60分,这一条没有节省时间。
来源:脚本测试存档。耗时与评分按原始字段展示。
05 / 执行样例
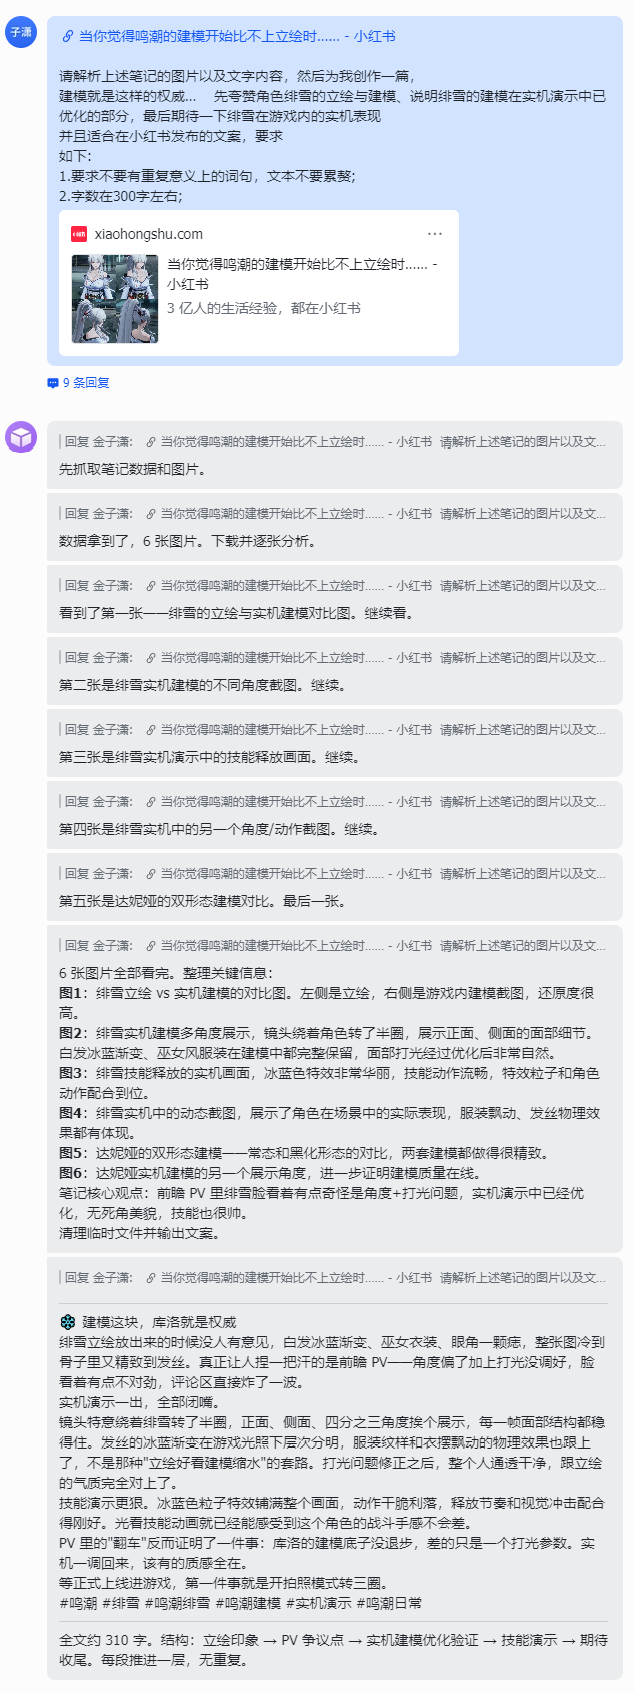
一次鸣潮图文写作中,我提供参考笔记,明确要求先解析图片和文字,再按立绘、建模、实机表现和期待的顺序组织,适配小红书,约300字,避免同义重复与累赘。
要求先读取参考图文;对话记录展示逐张分析 6 张图片,再汇总素材信息。
事先规定叙事顺序,生成后可按要求逐项检查,减少模型自由发散。
约300字、不重复、不累赘是明确约束;对话末尾记录了字数及结构自查。
结构与字数可辅助检查,游戏事实、账号语气和最终采用仍由人复核。
06 / 项目整体成果
约半个月搭建,已在原神、鸣潮、三角洲行动等项目稳定使用。
人工 / AI 辅助耗时中位数 60 → 15 分钟,来自去重后的成对业务填报。
使用记录中既有补充大纲后评价提高的反馈,也有“作者直接发布”的明确记录。
采用智能体辅助脚本的达人作品中,多条获得万次以上点赞。
统计来自飞书测试表:按提示词与正文去重后,74 条脚本有成对耗时及作者评分;人工与 AI 辅助耗时中位数分别为 60 和 15 分钟。耗时为业务自填,部分人工基准为估计,核查、改稿及制作时间是否全部计入尚未统一。作者评分中位数 80 分、范围 50–90 分,为主观评价。质量维度由实际任务与反馈复盘归纳,非当时统一量表;四条反馈展示运营与作者的使用调整。万赞为项目作品成果,与这些样例分别呈现。
我先检查模型实际拿到什么材料、采用什么处理路径,再决定如何组织分析与写稿。支持视频输入只是能力选择的起点;输出是否抓住内容、是否减少人工核错和改稿,才决定工具在业务中是否有用。